36氪
共 1035 条资讯-
最强大模型,保质期越来越短了
深流研究所
-
9点1氪丨马斯克花4000多亿买下00后公司;世界杯决赛门票转手价近230万美元
<p><strong>整理</strong>|孟孟 </p> <h2><strong>今日热点导览</strong></h2> <p>铁路部门将实行老年旅客购票优惠</p> <p>哈啰因未按规定备案、投放运营或者回收车辆再被罚款10万元</p> <p>网友称用豆包提前查到事业编成绩,官方回应 </p> <p>耐克将裁减1400个公司职位,主要集中在技术部门</p> <p>中国再发现两种月球新矿物,嫦娥五号样品研究获新突破</p> <h2><strong>TOP3大新闻</strong></h2> <p><strong>马斯克花4000多亿买下00后公司,SpaceX锁定Cursor补齐AI编程短板 </strong></p> <p>近日,SpaceX与AI编程初创公司Cursor达成一项收购协议:SpaceX获得以600亿美元(约合人民币4000多亿元)收购Cursor的选择权。Cursor由四名麻省理工学院辍学的“00后”学生于四年前创立,估值从2024年初的25亿美元飙升至2025年底的293亿美元,四位创始人每人所持股份价值至少13亿美元。</p> <p>Cursor付费用户超过100万,超半数《财富》500强企业使用该产品,英伟达CEO黄仁勋曾将其列为“推动人机协同数字劳动力革命的六家核心企业”之一。但Cursor依赖OpenAI的GPT和Anthropic的Claude,自身无底层大模型。马斯克则公开承认xAI在编程方面“落后”,正在重建。SpaceX旗下xAI拥有强大算力却缺应用产品,Cursor有产品却缺自主大模型,双方形成互补:Cursor将接入SpaceX的Colossus超算,SpaceX则补齐AI编程短板。分析认为,此举旨在构建“算力+模型+工具”闭环,AI竞争正从底层算力向应用层延伸。(21世纪经济报道)</p> <p><strong>世界杯决赛门票,转手价近230万美元</strong></p> <p>国际足联官方门票转售平台日前出现了4张2026年足球世界杯(美加墨世界杯)决赛的门票,每张票要价接近230万美元。据了解,这4张票是7月19日在新泽西州东拉瑟福德大都会人寿体育场举行的世界杯决赛门票,每张标价2299998.85美元,座位位于124区下层看台球门后方,第45排,座位号33至36。当天,该平台上的决赛门票最低价为10923.85美元。按照美国方面说法,国际足联并不控制门票在转售市场上的售价,但会向每张票的买方和卖方各收取15%手续费。(央视新闻)</p> <h2><strong>大公司/大事件</strong></h2> <p><strong>铁路部门将实行老年旅客购票优惠</strong></p> <p>据中国铁路公众号24日消息,铁路方面将实行老年旅客购票优惠。年满60周岁及以上的中国公民购买开车时间在5月30日至6月30日期间的非节假日周中时段(周一12:00至周五12:00)部分动车组列车车票,可享受执行票价9折优惠,实行“折上折”,铁路12306在相关优惠车次后标注“敬”字。年满60周岁及以上的持有残疾军人证、伤残人民警察证、国家综合性消防救援队伍残疾人员证的中国公民,在享受原有优待票价的基础上,可再享受9折优惠。老年旅客可同时享受普通常旅客会员的三倍积分优惠,积分可用于兑换火车票或办理座位升席业务。(中新经纬)</p> <p><strong>国家医保局全面进驻,湖南、河南被曝光串换药品药店</strong></p> <p>记者从国家医保局了解到,针对湖南、河南等地药店将化妆品、保健品和生活用品串换成药品使用医保卡结算的情况,国家医保局已于4月22日派出检查组前往两省进行调查核实,陆续进驻湖南省怀化市、衡阳市、株洲市、邵阳市,以及河南省郑州市相关药店进行检查。截至目前,已完成全部涉事机构进驻。(中新经纬)</p> <p><strong>哈啰因未按规定备案、投放运营或者回收车辆再被罚款10万元</strong></p> <p>4月24日,澎湃新闻记者注意到,上海市交通委官网显示,上海哈啰普惠科技有限公司(以下简称“哈啰公司”)因“互联网租赁自行车运营企业未按规定备案、投放运营或者回收车辆”被上海市交通委员会罚款10万元,处罚日期显示为4月22日。今年1月,哈啰公司因同样问题被罚款10万元。(澎湃新闻)</p> <p><strong>网友称用豆包提前查到事业编成绩,官方回应</strong></p> <p>4月23日晚间,有网友发帖称,“豆包查到2026山东事业编成绩了”,并附上一张成绩单,但成绩部分涂掉了。“不过好像只有津南槐荫区的能查,是不是属实咱也不知道,到底啥情况呀?”4月24日,扬子晚报记者联系上该网友了解到,帖子内容来自其他网友,但目前原帖网友已经删除了帖子。智灵动力(北京)科技有限公司副总裁郝雅婕分析告诉扬子晚报记者,应该是测试端口打开,被AI快速抓取到信息了。有可能是测试链接有一定规律,比如以 /kscj2025 年份结尾。豆包采集到往年的链接,按照往年链接的规律推断出来今年的成绩链接,可能和大模型幻觉和联想能力有关。(扬子晚报)</p> <p><strong>微软据报向7%的美国员工提供自愿退休方案</strong></p> <p>4月23日消息,据报道,微软首席人事官艾米·科尔曼在致员工的备忘录中推出了一项自愿退休计划,此举旨在为数千名长期任职的美国员工提供一个离职机会,并附带经济补偿及延长的医疗保健福利。该计划面向所有级别在67级(相当于高级总监级别)及以下的美国员工开放——但参与销售激励计划的员工除外——申请者的工龄与年龄之和必须达到70或以上,预计微软在美国的12.5万名员工中,约有7%(即约8750人)符合该计划的申请资格。(界面新闻)</p> <p><strong>挪威将禁止16岁以下儿童使用社交媒体</strong></p> <p>当地时间4月24日获悉,挪威政府将禁止儿童使用社交媒体,并将年龄限制设定
-
被中国新能源车吊打后,BBA坐不住了
<p>车展周这几天,不少同行发出过上述感慨。而要说大家为什么有这样的感觉,那自然是全球巨头与本土新势力的同台竞技,不同于往届某些时段的流量为王,参展商和新车的规模、密度都拉满,为车展带来了久违的纯粹感受。</p> <p>在这其中,BBA(奔驰、宝马、奥迪)在车展上呈现的东西,也能说出个一二。</p> <p>此次车展,BBA可以说是彻底放下身段,在“本土化、智能化、纯电化”等几个关键词下,带来了各自的重磅力作。其中,奔驰携近40款车型亮相,聚焦纯电产品的升级;宝马带来史上最强参展阵容,以“新世代”平台车型为核心,带来电动化与智能化转型成果;奥迪则聚焦本土化战略,推出专门适配中国市场的纯电车型,加速PPE平台的国产化落地。</p> <p>如果你关心车市,就轻易能发现,此次BBA三大品牌的参展姿态,与以往截然不同。</p> <p>因为它们本质上是在打一场救赎之战。过去,三大品牌更多是将海外车型原汁原味的引入中国,电动化产品多为燃油车型的“油改电”衍生,对应的产品在智能化、续航、本土化适配等方面严重脱节,导致其电动化车型销量惨淡,始终无法突破瓶颈。</p> <p>据统计,2025年,BBA在中国市场的纯电车型总销量不足30万辆,而同期蔚来、理想、小米和特斯拉等新品牌的单一品牌销量动辄突破20万辆,差距一目了然。</p> <p>因此,当中国新能源汽车渗透率突破50%,市场进入存量竞争阶段,消费者对豪华新能源车的需求,不再是单纯的品牌崇拜。加之,中国自主品牌在高端领域持续突破,豪华新能源市场的竞争进入白热化。这意味着,相较于以往燃油时代的绝对主导,如今的BBA,正面临着前所未有的转型压力。</p> <p class="image-wrapper"><img data-img-size-val="" src="https://img.36krcdn.com/hsossms/20260425/v2_111b2aeae9be42519886ebc07674d7f0@000000_oswg500136oswg1076oswg1306_img_000?x-oss-process=image/format,jpg/interlace,1" referrerpolicy="no-referrer"></p> <p>于是,BBA便借助北京车展的势头,携60多款重磅新车集体亮剑,其中电动化产品占据绝对主力,以全新的电动化产品,扭转市场对其新能源落后的印象,在中国市场实现翻盘。</p> <p>而如果能凭借此次参展实现破局,便能守住豪华市场的基本盘,甚至翻盘;若还是无法突破瓶颈,或将彻底沦为中国新能源市场的陪跑者。因此,这一战,既是BBA电动化转型的总结,更是其在中国市场的终局博弈的开端。</p> <h2><strong>01 BBA电动化失利与破局 </strong></h2> <p>要读懂BBA此次北京车展的电动化布局,我们有必要先复盘其过往的失利教训。因为那些曾经的失误,代价是巨大的。它不仅让BBA错失了中国新能源市场的黄金发展期,更让其在消费者心中的品牌形象受到冲击。</p> <p>回顾BBA的电动化之路,失利的原因大致集中在一下三点。一是“油改电”思维的固化;二是本土化适配不足;三是智能化滞后,未能跟上中国市场的迭代速度。</p> <p>以奔驰为例,早期推出的纯电EQC车型,基于燃油GLC平台改造,续航较低,座舱体验一般,最终销量惨淡;宝马的iX3、i3等车型,同样存在本土化不足的问题,智能驾驶辅助系统适配性差;奥迪则步伐迟缓,PPE平台量产电动化车型迟迟未能落地,错失市场机遇。</p> <p>基于此,我们得以看到奥迪在4S店挂出“奥迪也有新能源”横幅的心酸,这是BBA初期电动化失利的缩影。</p> <p class="image-wrapper"><img data-img-size-val="" src="https://img.36krcdn.com/hsossms/20260425/v2_1d26a38ecd284dccad92332451dca87d@000000_oswg111432oswg1080oswg608_img_000?x-oss-process=image/format,jpg/interlace,1" referrerpolicy="no-referrer"></p> <p>而痛定思痛后,BBA终于调整电动化思路,此次北京车展亮相的电动化产品,便是它们全新思路的最佳体现,每一款车型都针对性解决过往的短板,展现出更强的竞争力。</p> <p>具体看来,奔驰此次携近40款车型亮相,电动化产品成为绝对主力,其中全新奔驰纯电GLC SUV全球首秀、全新奔驰纯电CLA 260 L中国上市,构成了其电动化布局的核心。</p> <p>作为奔驰近年来最畅销车型的首款纯电车型,全新纯电GLC SUV摆脱“油改电”,基于全新纯电平台打造。在智能层面,搭载AI赋能的智能座舱,配合强化学习大模型的辅助驾驶系统,试图彻底解决以往智能驾驶适配性差的问题。</p> <p>另外,全新纯电CLA 260 L的上市,则进一步完善了奔驰的豪华电动产品矩阵,精准切入中型纯电轿车市场,定价亲民,同时延续奔驰的豪华质感,试图抢占年轻消费者市场。</p> <p>2026年,正值梅赛德斯-奔驰诞生140周年,此次参展阵容也承载着品牌的传承与革新,彰显其发力电动化的决心。值得一提的是,奔驰全新纯电车型已全面推行“一口价”销售模式,取消终端议价环节,重塑价格体系,降低消费者决策成本,应对新势力直营模式的冲击。</p> <p>对于中国市场的电动化革新与长期布局,奔驰早已定下清晰的战略蓝图。奔驰集团董事会主席康林松(Ola Källenius)表示:“至2027年,梅赛德斯-奔驰将推出超过40款全新车型,覆盖多元动力形式,其中包括7款专为中国市场打造的车型。”足以看出,奔驰不再固守全球统一化产品策略,而是深度贴合中国用户需求定制产品,全力补齐电动化短
-
实测DeepSeekV4:天下武功,唯快不破
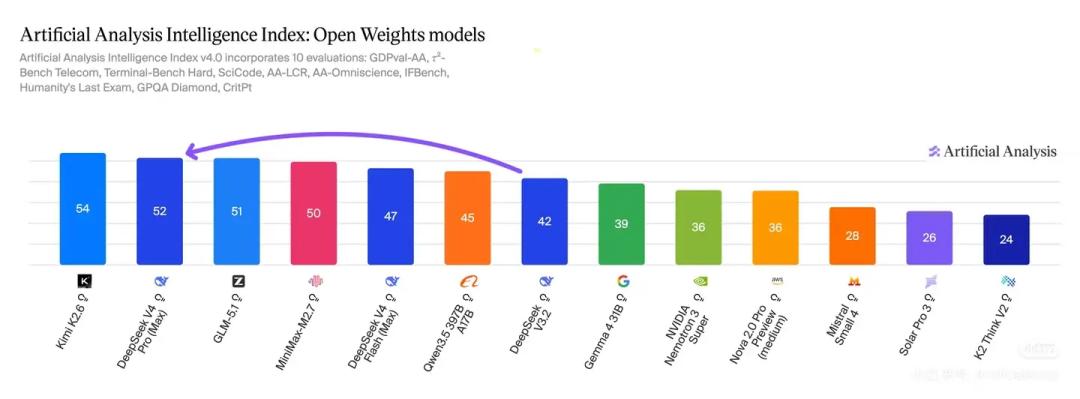
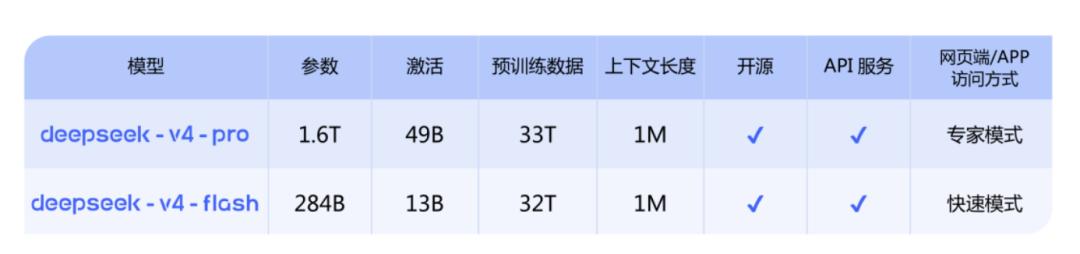
<p>“跳票”许久的DeepSeek-V4,终于来了。</p> <p>几个小时前,DeepSeek-V4预览版上线并开源。巧的是,几乎同一天,OpenAI也推出了GPT-5.5。一个继续讲闭源生产力系统,一个继续讲开源、长上下文和低成本推理。中美AI产业中流量最大的两家基模公司,在同一天相遇。</p> <p>DeepSeek-V4分为Pro与Flash两个版本,均支持百万(1M)token超长上下文,总参数规模分别达到1.6T(激活49B)与284B(激活13B)。。</p> <p class="image-wrapper"><img data-img-size-val="693,135" src="https://img.36krcdn.com/hsossms/20260424/v2_d2cfb43e81ce456c9e84fe6efe4e0544@6119835_oswg41734oswg693oswg135_img_000?x-oss-process=image/format,jpg/interlace,1" referrerpolicy="no-referrer"></p> <p><strong>不过,相比起“1.6T参数”或者 “百万token上下文”这两个夸张数字,技术文档里的两个十位数更值得关注:27%和10%。</strong></p> <p>根据HuggingFace上V4系列的介绍,在100万token上下文场景下,V4-Pro的单token推理FLOPs只有V3.2的27%,KVcache只有V3.2的10%。</p> <p>翻译成人话就是,在处理超长材料的场景下,V4不只是“能装得下”,而且跑得更快、还更便宜。</p> <p>这也许是是V4这次更新中最值得关注的地方。</p> <p><strong>过去半年,长上下文已经成了头部模型的共同卖点。Claude、Qwen、Kimi、GLM都在往长文本、代码仓库和Agent任务上走,DeepSeek这次把主线放在了长文本场景里最贵的部分:计算和缓存。</strong></p> <p>略显遗憾的是,V4目前并没有原生多模态功能,这会限制它在一些场景的发挥。</p> <p>所以,V4的关键词,并不是行业内期盼已久的“新物种”,而是“效率工程”的再进一步。</p> <p>回顾过往也确实如此,DeepSeek这家公司,一直都不是那种“性感”产品的路线,在Token调用暴涨的海洋中,V4要撑起的,是这家超级独角兽200亿美元估值的野望。</p> <h2><strong>更快,但是没有原生多模态</strong></h2> <p>身处2026年的今天,大模型支持长上下文已经不稀奇。但是另一个问题也随之而来:模型处理超长文本、超长链路的情况下,还能不能高效地继续工作。</p> <p>一个模型如果只看几段文字,回答问题并不难;但如果让它看完整代码仓库、几十份合同、几个月会议记录,再持续生成、检索、改代码、调用工具,这个事情的难度会指数级增加。</p> <p>V4-Pro的单token推理FLOPs只有V3.2的27%,KVcache只有V3.2的10%,正好对照着这个问题的答案。</p> <p><strong>前者指向每生成一个token所需的计算量,后者指向KVcache占用。KVcache可以理解成模型处理长文本时需要随身携带的“工作记忆”。</strong></p> <p class="image-wrapper"><img data-img-size-val="693,261" src="https://img.36krcdn.com/hsossms/20260424/v2_ad657d2a69504d1ebaedb1741b202d20@6119835_oswg92462oswg693oswg261_img_000?x-oss-process=image/format,jpg/interlace,1" referrerpolicy="no-referrer"></p> <p>文本越长,这份工作记忆越重;如果每一步都背着完整包袱走,模型就很难轻快起来。</p> <p>所以,天下武功,唯快不破。</p> <p>这里的快,不是聊天窗口里早几秒回答,而是长文本任务中的运行效率。吃下1M文本之后之后,模型还能不能跑得动、跑得起,能不能支撑高频调用。</p> <p><strong>这一点在今天上线的GPT5.5中也有所体现,很多ChatGPT用户惊呼,GPT5.5-Thinking的响应速度,快了一不是一星半点。</strong></p> <p>结合眼下爆火的Agent工作流,这项指标提升就更为关键。包括OpenClaw在内的系统级Agent工具,在运行任务时,往往需要读文件、查资料、调用工具、修改代码、保存中间状态,再根据反馈继续下一步。</p> <p><strong>任务越真实,上下文越长,计算和缓存负担越容易滚雪球。很多Agent产品今天看起来像未来,一算成本就像灾难。V4如果真能把长上下文下的运行效率压下来,影响的是整个Agent工具链的成本结构。</strong></p> <p>字母AI也简单上手体验了一下DeepSeek V4Pro,我们搭建了一个简易的离线环境,跑了两个贴近日常用户场景的测试。</p> <p class="image-wrapper"><img data-img-size-val="693,453" src="https://img.36krcdn.com/hsossms/20260424/v2_eeb05c1a87494827a94320f25b8b86bc@6119835_oswg213724oswg693oswg453_img_000?x-oss-process=image/format,jpg/interlace,1" referrerpolicy="no-referrer"></p> <p>首先,我们给了V4 Pro一
-
DeepSeek-V4发布,黄仁勋的担忧成真了
<p>“如果顶尖的AI模型被优化在华为芯片上运行,对美国而言将是‘可怕的后果’。”</p> <p>这是英伟达CEO黄仁勋近期在一档播客节目中发出的警告。让他发出警告的对象,是即将发布新模型的中国AI公司DeepSeek。</p> <p>让黄仁勋警惕的,并不是某个具体的模型能力,而是另一件事——综合多家权威媒体报道: DeepSeek-V4 模型在设计之初便优先围绕华为昇腾AI体系进行适配。</p> <p>一旦成功绕过英伟达的CUDA体系,DeepSeek将不再只是英伟达生态里的一个“租户”,被迫接受高昂的“算力租金”和随时可能断供的供应链风险,而是成为能自主定义算力效率、掌握技术栈主导权的“规则制定者”。</p> <p>黄仁勋的这种担忧在今天(4月24日)成为了半个现实。</p> <p>沉寂近五个月后,DeepSeek带着V4重新回到市场中心,在其定价说明中,有一行几乎被忽略的灰色小字:<strong>受限于高端算力,目前Pro的服务吞吐十分有限,预计下半年昇腾950超节点批量上市后,Pro的价格会大幅下调。</strong></p> <p>这一细节至少说明,<strong>国产算力已经在DeepSeek的整体体系中占据了重要位置,甚至在关键路径上开始影响其成本结构与定价逻辑。</strong></p> <p>这并不意味着既有格局被打破。从技术报告来看,DeepSeek当前最成熟、最稳定的实现仍然建立在CUDA体系之上,核心算子与工程优化依旧集中在英伟达生态内。这也意味着,在短期内,CUDA仍然是行业默认的“最优路径”。</p> <p>只是,DeepSeek-V4也证明了,CUDA构建的城墙,已经不再坚不可摧。</p> <h2><strong>DeepSeek-V4都做了什么</strong></h2> <p>DeepSeek-V4实际上就干了一件事:用极致的工程效率,把“顶级大模型”的门槛打了下来。它没有单纯堆砌参数,而是通过一套组合拳,让高性能AI变得既好用又便宜。</p> <p>具体来看,首先是参数规模:旗舰版本DeepSeek-v4-pro总参数达1.6万亿,但每次推理仅激活490亿参数;轻量版本DeepSeek-v4-flash则控制在2840亿参数、130亿激活规模。</p> <p class="image-wrapper"><img data-img-size-val="1080,400" src="https://img.36krcdn.com/hsossms/20260424/v2_d20d8d8f49524e24be3ebe9cf675f4cb@6101715_oswg60280oswg1080oswg400_img_000?x-oss-process=image/format,jpg/interlace,1" referrerpolicy="no-referrer"></p> <p class="img-desc">● 同一时期国内主流大模型参数对比。制图:镜相工作室</p> <p>两个版本背后的逻辑一致:通过MoE(混合专家)架构,在不显著增加实际算力负担的前提下扩展模型容量。通过工程优化,让模型在推理时只调用最相关的部分,从而实现低成本下的顶级性能。这种结构换算力的思路在V2时期已初见成效,在V4中被进一步放大。</p> <p>在上下文能力上,DeepSeek直接将100万tokens作为“所有官方服务的标配”。相当于你用它的App、网站或API,默认就能一次性上传一整本《红楼梦》、整个项目的代码库或一份完整的年度报告,让AI从头到尾读完并处理。</p> <p>在行业中,长期存在上下文越长,成本越高的矛盾。传统的AI模型为了理解长文本,它需要记住每个字,并且计算每个字和全文中其他所有字的关联。相当于为了一句话,就需要翻阅并重读整本字典,效率极低,成本也高。</p> <p>而V4没有硬扛这个数学难题,而是用DSA稀疏注意力(DeepSeek Sparse Attention)的新机制,通过“打包摘要”和“只抓重点”,大幅降低了处理和记忆长文的计算量与成本。百万字的长文在AI的“工作内存”(显存)里,就变成了几百个高度浓缩的要点,体积和负担骤减。</p> <p>如果这一机制能够在真实场景中稳定运行,那么长上下文能力将从高端模型的附加项,逐渐转向应用层的基础配置。</p> <p>再来看能力层面的变化:</p> <p>Agent能力方面,V4-Pro已进入开源模型的第一梯队。在Agentic Coding评测中,其表现达到当前开源最优水平,并在内部直接作为工程团队的编码工具使用。评测反馈中一个颇具参考价值的细节是,<strong>其输出质量已经接近美国AI企业Anthropic高端模型的常规非思考模式,但在更复杂的思考模式上仍有差距。</strong></p> <p>推理能力方面,在数学、STEM以及竞赛级代码任务中,V4-Pro的表现超过现有公开评测中的开源模型,并逐步逼近顶级闭源产品。</p> <p>世界知识方面,V4-Pro大幅领先其他开源模型,和谷歌的顶尖闭源模型Gemini-Pro-3.1存在差距。</p> <p>这些能力并非孤立存在,而是围绕具体应用场景展开。V4针对Claude Code、OpenClaw、CodeBuddy等主流Agent工具进行了适配,在代码生成与文档处理等任务中优化表现。可以看出,它的目标并不是成为最全面的模型,而是更直接地嵌入开发流程,承担实际生产任务。</p> <p>系统层面则藏着DeepSeek能够便宜下来的“秘密”。</p> <p>技术报告显示,DeepSeek在系统底层做了一套“细粒度专家并行 (EP) ”方案,简单理解,就是优化了AI模型在芯片上的“调度算法”,让计算和通信能像流水线一样重叠进行。</p> <p>这套方案已在英伟达GPU与华为昇腾NPU两套体系上完成验证,推理速度提升了约1.5到2倍。这意味着同样的芯片,能处理更多的用户请求,
-
DeepSeek V4终于发布,但它留下的5道主观题还没有答案
阿菜cabbage